本地视觉模型对比小记
目录
今天尝试了一下在M4 Pro 24G 内存的MacBook本地跑视觉模型,候选有两个:Qwen3-VL-30B-A3B-Thinking-4bit 和 gemma-4-26B-A4B-4bit。都是 MoE 架构的 4bit 量化版,一个 30B 总参激活 3B,一个 26B 总参激活 4B,在 Mac 上用 MLX 的 mlx_vlm.generate 都能跑得动。拿两张图简单各测了一轮,只能说是:各有优劣。
一、第一轮:看图说话
任务很朴素:一张黑底测试图,左边一个红色方块,右边一个绿边的深蓝圆,底部一行白字「TEST 2026-08-30」,提示词是「详细描述这张图片里的内容,包括形状、颜色和文字」。
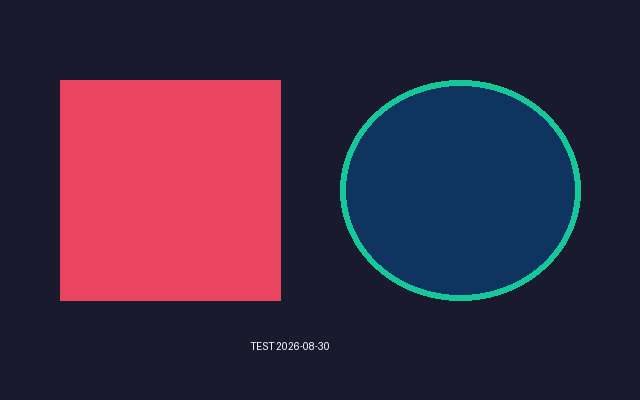
两个模型都没看错图——基本要素两边描述一致,底线都守住了。差异在风格:
- Qwen 像个认真的学生:先在
<think>思维链里写了一大段(494 个输出 token 里差不多三分之二花在这上面),然后给出一段面面俱到的描述,文字部分连版式都还原了出来; - Gemma 像个老练的同事:不绕弯子,一段描述直接收工,颜色叫得更准——Qwen 说「深蓝色」,Gemma 给出的描述跟肉眼更贴。
质量上互有胜负:Qwen 赢在文字细节,Gemma 赢在颜色精度。但效率的差距就没这么客气了:Gemma 端到端约 6.2 秒,Qwen 约 11.5 秒,差出近一倍;峰值内存 17.0 GB 对 19.1 GB。对一张简单测试图来说,thinking 链是纯粹的税。
二、第二轮:UI 评审
第二轮换张有难度的:两个 UI 设计稿并排放,问「图中两个ui设计图,哪个更好?」。这类题没有标准答案,考的是模型的分析框架。
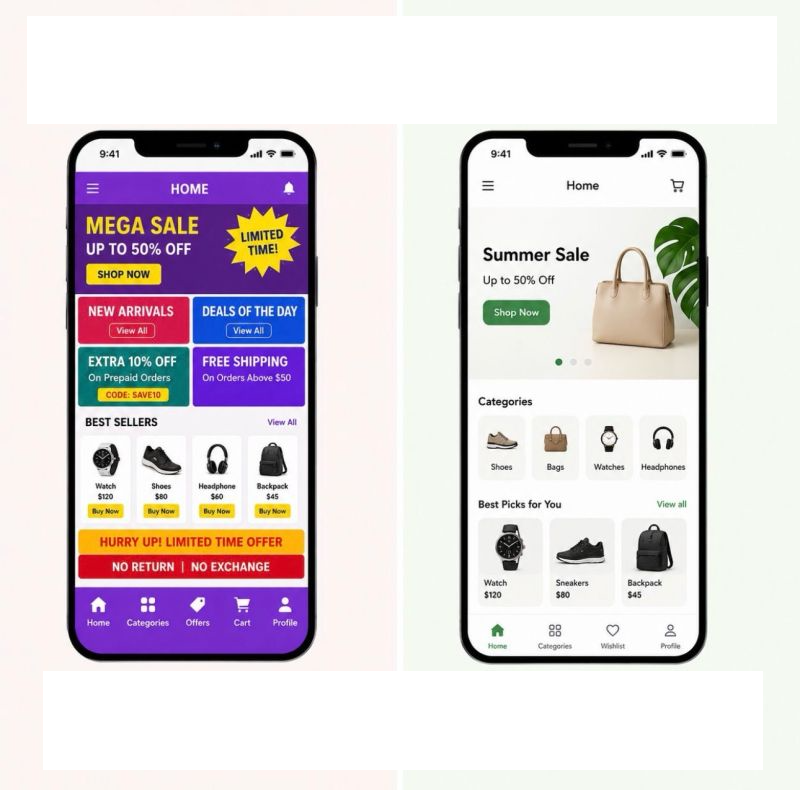
左边是紫色调高饱和的促销风电商界面,右边是浅色极简的品牌风界面。两个模型的回答代表了两种流派:
- Qwen 快刀斩乱麻:直接站队右边,留白、层级、可读性,理由列得整整齐齐。适合就是要一个明确答案的场景;
- Gemma 先问「这是什么产品」:把左边类比成拼多多/Temu 式的转化优先设计,右边类比成 Apple/Zara 式的品牌优先设计,结论是「取决于产品定位」,再按通用电商标准倾向右边。像一份浓缩的设计评审意见。
主观题上我更欣赏 Gemma 的答法——「哪个更好」这种问题,直接给答案不如给判断框架。但这轮真正值得记的是另一组数字:同一张图,Qwen 编码成 647 个输入 token,Gemma 只要 280 个,2.3 倍的差距。图像 token 是视觉模型最隐蔽的成本,它既决定提示词处理的时间,也决定上下文窗口被吃掉的速度。再加上这轮 Gemma 的提示词处理跑出 198 tok/s(Qwen 是 65),端到端 15.8 秒对 19.0 秒。
三、两轮账本
| 指标 | Qwen 第一轮 | Gemma 第一轮 | Qwen 第二轮 | Gemma 第二轮 |
|---|---|---|---|---|
| 端到端耗时 | ≈11.5 s | ≈6.2 s | ≈19.0 s | ≈15.8 s |
| 输入 tokens | 265 | 301 | 647 | 280 |
| 输出 tokens | 494 | 222 | 734 | 886 |
| 解码吞吐 | 86.9 tok/s | 62.9 tok/s | 81.7 tok/s | 61.4 tok/s |
| 峰值内存 | 19.1 GB | 17.0 GB | 19.3 GB | 17.0 GB |
几个观察:
- Qwen 的解码吞吐其实一直更高(80+ 对 60+ tok/s),但架不住 token 花得多——第一轮交 thinking 的税,第二轮交图像编码的税,两头都没省下;
- Gemma 的峰值内存稳定在 17.0 GB,Qwen 在 19.1 到 19.3 GB 之间。对统一内存的 Mac 来说,这 2 GB 可能就是「旁边还能开个浏览器」和「开不了」的区别;
- 端到端耗时 = 输入 token ÷ 提示词吞吐 + 输出 token ÷ 解码吞吐,标称速度只是账面数字,真正决定体感的是「为了这道题,总共烧了多少 token」。
四、怎么选
- 要直接答案、精细 OCR、复杂推理链:选 Qwen。thinking 模型在真需要推理的任务上仍有优势,文字转录也更完整;
- 要长分析、平衡判断、省内存省时间:选 Gemma。图像 token 效率是它的隐藏王牌;
- 简单任务别上 thinking 模型。那几百个 token 的思维链不会让「描述一张图」变得更好,只会让它变得更慢。
尾声
这次对比最大的收获不是「谁更强」,而是看清了两个隐蔽成本:思维链的 token 税和图像编码的 token 税。前者在简单任务上纯付损耗,后者则藏在输入端,不翻日志根本看不见。
下一轮想试试非 thinking 版本的 Qwen3-VL,再换更大的图和长文档 OCR 跑一轮,看看这两笔税各能省下多少。